Firmowa strona otwiera się w Warszawie w ułamku sekundy, ale klient z Hamburga czeka na jej załadowanie 3 razy dłużej? Powód jest prosty – dane potrzebują czasu, żeby pokonać określoną odległość. Edge computing służy skróceniu tego dystansu. Wyjaśniamy, na czym polega i kiedy przydaje się firmowej witrynie.
Edge computing – co to jest?
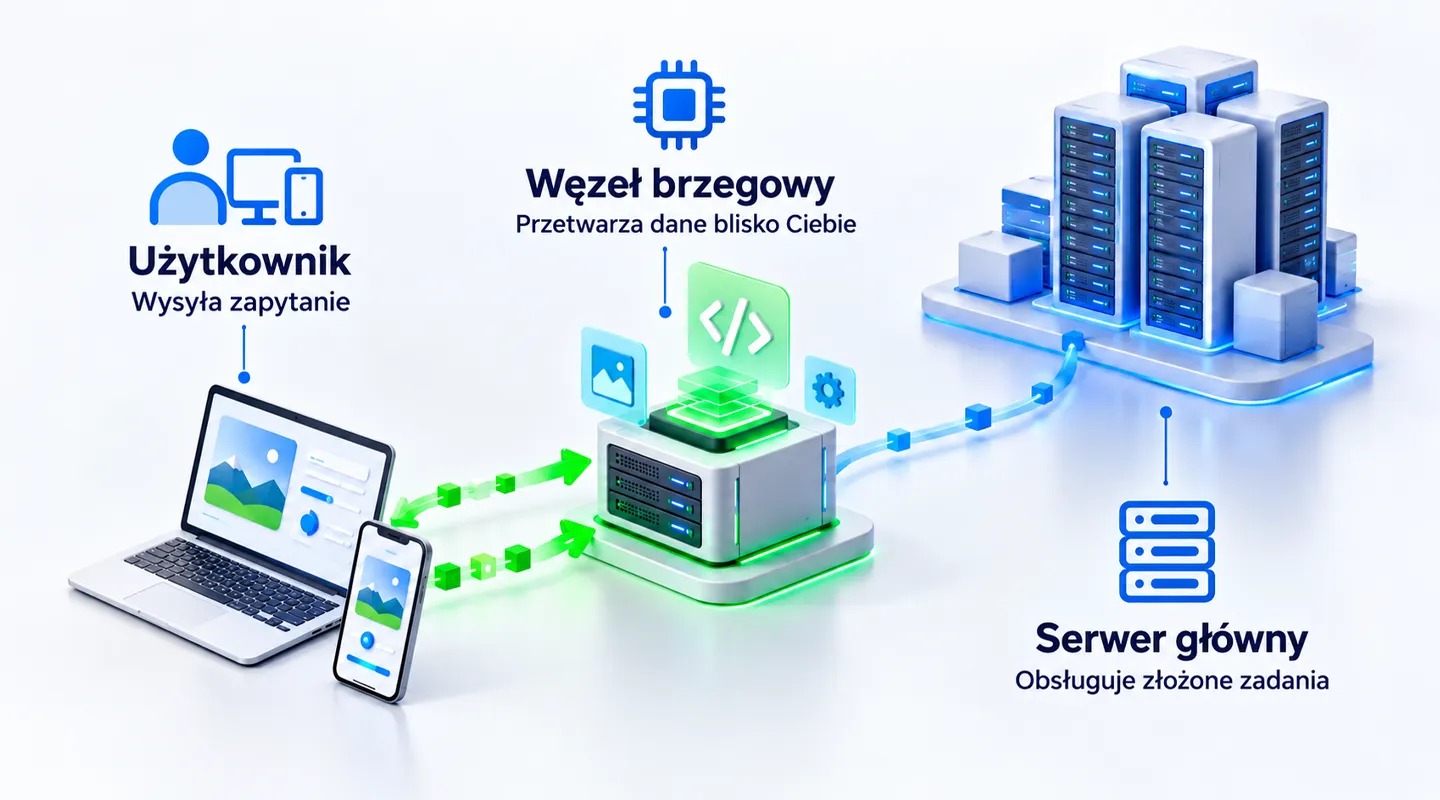
Edge computing polega na przetwarzaniu danych bliżej użytkownika, zamiast przesyłania ich do jednego, głównego centrum danych. Zapytanie nie wędruje wtedy na drugi koniec kontynentu, tylko trafia do serwera oddalonego o kilkadziesiąt kilometrów.
Przez ostatnie 20 lat internet działał w modelu scentralizowanym. Firma umieszczała stronę i aplikację na serwerze w jednej lokalizacji, a wszyscy odwiedzający – niezależnie od tego, skąd się łączyli – trafiali właśnie tam. Przy prostych witrynach nie stanowiło to problemu. Sytuacja zmieniła się wraz z rozwojem aplikacji internetowych, sklepów z tysiącami produktów i serwisów, które muszą reagować natychmiast.
Odpowiedzią stało się rozproszenie mocy obliczeniowej. A zatem co to jest edge computing w codziennej praktyce? To sieć niewielkich węzłów rozmieszczonych geograficznie, z których każdy potrafi samodzielnie wykonać część zadania: obsłużyć zapytanie, przetworzyć dane, zweryfikować użytkownika czy dobrać treść do jego lokalizacji. Zastosowanie tego rozwiązania sprawia, że do centralnego serwera trafia wyłącznie to, co musi.
Edge computing po polsku – jak to nazwać?
Edge computing po polsku określa się najczęściej jako przetwarzanie brzegowe albo przetwarzanie na krawędzi sieci. Oba tłumaczenia opisują to samo zjawisko: „brzeg” to miejsce, w którym sieć styka się z użytkownikiem końcowym.
W rozmowach branżowych dominuje angielski oryginał, ale polski odpowiednik przydaje się choćby przy dokumentacji przetargowej czy opracowaniach dotyczących infrastruktury cyfrowej.
Jak edge computing wpływa na szybkość działania strony?
Edge computing przede wszystkim przyspiesza ładowanie się strony. Wynika to z prostych praw fizyki. Sygnał w światłowodzie porusza się z ograniczoną prędkością, więc każde tysiąc kilometrów, na który musi być przesłany, oznacza dodatkowe milisekundy opóźnienia. Przy pojedynczym zapytaniu to niewiele, ale przeciętna strona wymienia ich kilkadziesiąt.

Skrócenie dystansu daje kilka wymiernych efektów, m.in.:
- niższe opóźnienie – serwer odpowiada szybciej, ponieważ dane nie muszą pokonywać tysięcy kilometrów,
- szybsze pierwsze wczytanie – użytkownik widzi treść wcześniej, co ma znaczenie zwłaszcza na łączach mobilnych,
- mniejsze obciążenie serwera głównego – węzły brzegowe przejmują część pracy, więc centralna infrastruktura zachowuje zapas mocy na wzrosty ruchu,
- większa odporność na awarie – gdy jeden węzeł przestaje działać, ruch przejmuje kolejny, a odwiedzający zwykle niczego nie zauważa.
W sklepie internetowym przekłada się to bezpośrednio na sprzedaż. Badania od lat pokazują tę samą zależność: im dłużej ładuje się strona, tym więcej osób ją opuszcza. Każda sekunda opóźnienia oznacza więc wyższe ryzyko utraty klienta.
Czytaj też: Co to jest TTFB i jakie ma znaczenie?
Edge computing a CDN – czym to się różni?
Różnica między edge computing a CDN polega na tym, jakie zadania wykonują te serwery.
CDN przechowuje kopie gotowych plików – grafik, arkuszy stylów, skryptów, materiałów wideo – i udostępnia je z najbliższej lokalizacji. Sprawdza się przy treściach, które się nie zmieniają. Sęk w tym, że gdy strona musi wygenerować indywidualną, spersonalizowaną zawartość, na przykład zawartość koszyka albo panel klienta, zapytanie i tak trafia do serwera głównego.
Węzeł brzegowy wykonuje szerszy zakres zadań: nie tylko przechowuje pliki, ale też uruchamia kod. Może sprawdzić uprawnienia użytkownika, dopasować treść do jego lokalizacji, przefiltrować ruch pod kątem bezpieczeństwa czy obsłużyć proste zapytanie do bazy danych. Do centrum danych trafiają dopiero cięższe operacje.
Warto jednak podkreślić, że granica między tymi pojęciami w ostatnim czasie się zaciera. Większość dostawców CDN-u oferuje obecnie także funkcje przetwarzania brzegowego, a edge computing traktowany jest jako naturalne rozwinięcie tej samej koncepcji.
Google edge computing – co to zmienia dla widoczności strony?
Google edge computing może pomóc w poprawie szybkości strony, a tym samym jej wyników w obszarze Core Web Vitals. Jednak nie jest czynnikiem, który sam w sobie podnosi stronę w wynikach wyszukiwania.
Skąd ten związek? Google bierze pod uwagę doświadczenie użytkowników, a jednym z jego elementów jest szybkość działania witryny. Core Web Vitals pokazują m.in. jak szybko pojawia się główna treść strony i jak szybko witryna reaguje na działania użytkownika.
Na te wyniki wpływa nie tylko kod strony. Znaczenie ma również serwer, na którym jest ona uruchomiona. Jeśli znajduje się daleko od użytkownika albo jest przeciążony, czas oczekiwania rośnie – nawet wtedy, gdy sama strona została dobrze zoptymalizowana. Ma to szczególne znaczenie dla firm, które obsługują klientów w kilku krajach. Użytkownik z zagranicy może znajdować się setki lub tysiące kilometrów od głównego serwera. Przy rozproszonej infrastrukturze jego zapytanie może trafić do lokalizacji znajdującej się bliżej niego, co skraca czas oczekiwania na odpowiedź.
Google zbiera dane o szybkości stron na podstawie rzeczywistych wizyt. Jeśli więc witryna jest wolna dla części użytkowników, również z innych krajów, znajdzie to odzwierciedlenie w danych dotyczących jej działania.
Kiedy warto pomyśleć o przetwarzaniu brzegowym w firmie?
Przetwarzanie brzegowe zaczyna się opłacać, gdy:
- sprzedajesz albo świadczysz usługi poza Polską i część ruchu przychodzi z odległych rynków;
- prowadzisz sklep lub aplikację, w której użytkownik wykonuje wiele czynności w krótkim czasie;
- witryna notuje gwałtowne wzrosty ruchu, na przykład przy kampaniach sezonowych;
- zależy Ci na dodatkowej warstwie ochrony, która odsiewa podejrzany ruch, zanim dotrze on do serwera głównego.

Ale uwaga! Nie każda firma potrzebuje takiego rozwiązania. Przy prowadzeniu wizytówkowej strony dla lokalnego biznesu, gdy wszyscy klienci znajdują się w Polsce, dobrze skonfigurowany hosting z szybkimi dyskami i sensownym cache'owaniem w zupełności wystarczy.
W pozostałych sytuacjach warto zacząć od podstaw: aktualizacji wersji PHP, kompresji zdjęć, cache'owania po stronie serwera oraz hostingu, który nie umieszcza Twojej strony obok kilkuset innych. Dopiero gdy te elementy działają prawidłowo, rozproszenie infrastruktury przyniesie zauważalną różnicę.
Czytaj też: Szybkość ładowania strony – co wpływa na wydajność witryny?

Czy wiesz, że… hosting stron www w NQ.pl korzysta z serwerów LiteSpeed, dysków NVMe SSD, obsługi HTTP/3 oraz pamięci Redis? Dla większości firmowych witryn to wystarczy, aby zapewnić optymalną szybkość ładowania witryny.
Nie wiesz, czy Twoja strona wymaga rozproszonej infrastruktury, czy po prostu lepszego hostingu? Odezwij się do nas – pomożemy to ocenić.